
Im Dezember 2023 hat die „New York Times“ Klage gegen OpenAI (aktuell das wohl bedeutendste Start-up der Welt) und deren Hauptgesellschafter Microsoft eingereicht. Den Entwicklern der KI-Software ChatGPT wird vorgeworfen, auf Kosten der NYT ein neues Geschäftsmodell aufgebaut zu haben, indem diese das Wissen aus Millionen von journalistisch hochwertigen „Times“-Artikeln ohne Erlaubnis und Vergütung zum Training ihrer KI genutzt haben und aktuell nutzen. Die zur Diskussion stehenden urheberrechtlich relevanten Handlungen beziehen sich zunächst auf den Kopiervorgang, der erforderlich ist, um die Artikel in den Satz der Trainingsdaten einzufügen. Kein Angriffspunkt hingegen ist der reine Lesevorgang durch die KI. Dieser nämlich fällt unter die gemeinhin freie Inspiration. Problematisch wird es erst wieder beim „Output“ der KI, wenn nämlich dieser – so der Vorwurf der NYT – mitunter keine neuen Texte, sondern lediglich Plagiate mancher Times-Artikel „ausspuckt“. Diese nämlich können dann vergütungsfrei verbreitet werden, obwohl die originären Artikel hinter einer Paywall versteckt sind. Die NYT möchte als Ausgleich für diese aus ihrer Sicht erfolgten Rechtsverletzungen nunmehr eine Entschädigung durchsetzen. Der Klage sind langwierige (erfolglose) Lizenzverhandlungen vorausgegangen.
Im Januar 2024 reagierte OpenAI in einem Blogpost erstmals öffentlich auf die Vorwürfe. Etwaige Plagiate im „Output“, so ihre Argumentation, seien auf Fehler im System zurückzuführen, an denen gerade gearbeitet werde. Vor allem aber bezieht sich OpenAI auf die „Fair Use“-Ausnahme des US-amerikanischen Urheberrechts. Danach sind alle Nutzungen von urheberrechtlich geschütztem Material frei, wenn diese „fair“ sind und z.B. nicht-kommerziellen Forschungszwecken dienen. Um dieses Argument zu verstehen, muss man wissen, dass das Training ihrer KI in einem von der Vermarktung unabhängigen Non-Profit-Unternehmenszweig stattfindet. Diesen „Trick“ wenden wohl diverse US-Entwickler von Sprachmodellen an, um sich auf „fair use“ beziehen zu können.
Mit dem Verlagshaus Axel Springer allerdings hat OpenAI inzwischen eine entsprechende Vereinbarung treffen können, wie im Dezember 2023 gemeldet wurde. Zusammenfassungen ausgewählter Nachrichteninhalte - mit Verlinkungen zu „Axel Springer“ - sollen demnächst gegen Vergütung für das Training zur Verfügung gestellt werden. Im Gegenzug soll OpenAI dem Verlagshaus beim Aufbau einer KI-Strategie behilflich sein, wie es heißt.
Weiterlesen
Zum Thema Urheberrecht & KI
Nachricht · Urheberrecht & KI
Delaware: 1. US-Urteil zum KI-Training, 5 J. Verhandlung, „Headnotes sind wie Skulpturen“
Am 12.02.2025 hat das Bezirksgericht für Delaware als erstes US-Gericht das KI-Training mit unlizenzierten…
· 2 Min.
Nachricht · Urheberrecht & KI
LAION – KI und Urheberrecht, Text-/Data Mining
Das Landgericht Hamburg hat als erstes deutsches Gericht über einen KI-Copyright-Fall entschieden. Im Zentrum…
· 2 Min.
Essay · Satire & Meinungsfreiheit
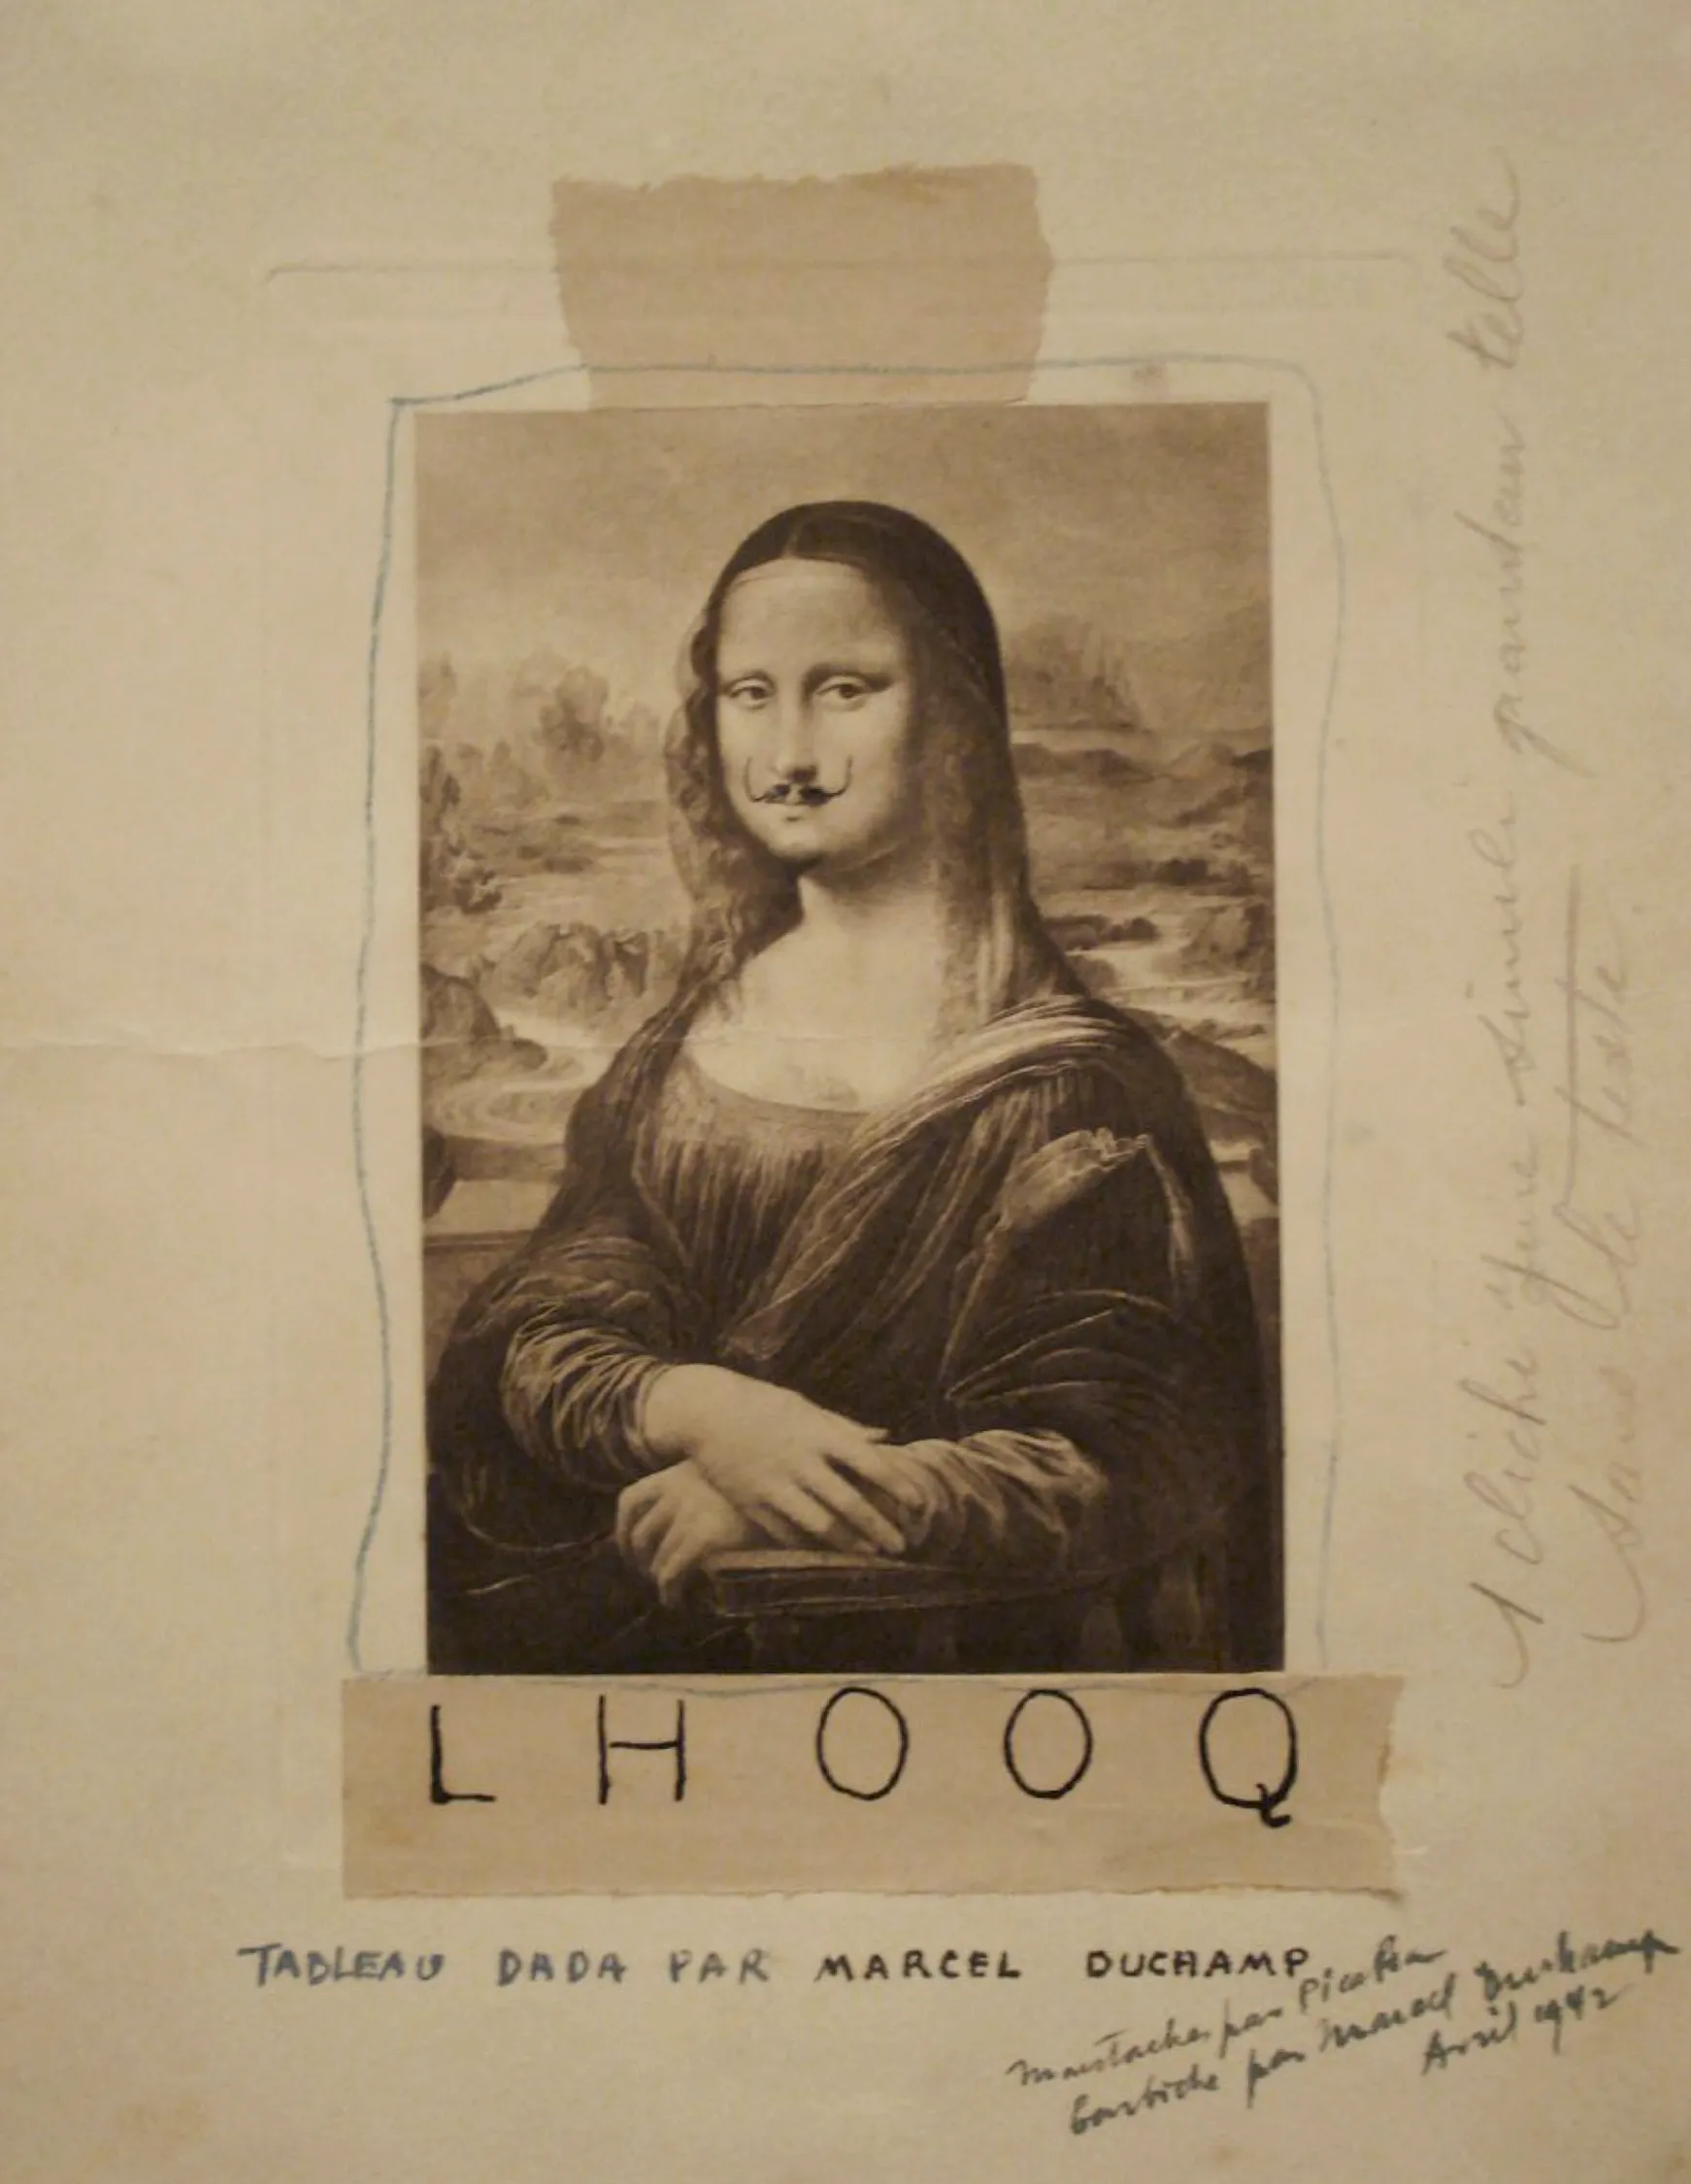
Memes und ihre Vorläufer: Duchamps „Mona Lisa“, UrhDaG, Pastiche, Kippenbergers „Paris Bar“
Über das heikle „Spiel“ mit Kopien und Referenzen nach dem Urheberrecht.
· 6 Min.